Generatore di UUID: v4, v7, v5 ed elenchi in blocco
Un buon generatore di UUID ti dà la versione che vuole il tuo database, scritta esattamente come se la aspetta, e ti dice che cosa è davvero qualsiasi UUID tu incolli. Tutto quello che trovi qui sotto gira nel tuo browser.
Generatore di UUID
Ancora niente. Gli UUID generati restano solo in questo browser.
Quale versione dovrebbe darti un generatore di UUID?
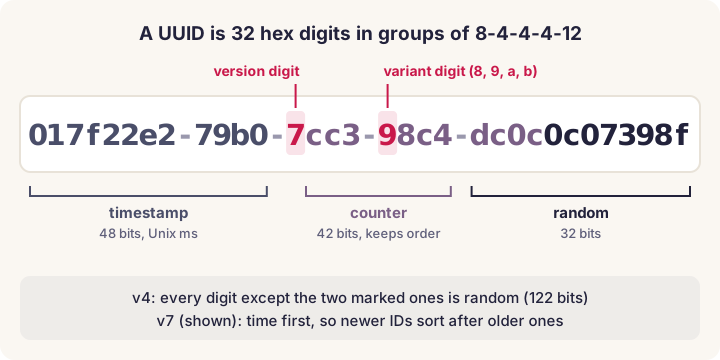
Ogni UUID è fatto di 128 bit scritti come 32 cifre esadecimali in cinque gruppi, 8-4-4-4-12. Due di queste cifre servono a fare ordine: la 13ª cifra è la versione, la 17ª porta la variante (8, 9, a o b per gli UUID RFC 9562). Tutto il resto dipende dalla versione: bit casuali, un timestamp, un contatore o un hash. Scegliere la versione significa, in pratica, scegliere che cosa vuoi dentro la tua chiave.
| Versione | Cosa contiene | Quando usarla |
|---|---|---|
| v4 | 122 bit casuali | La scelta sicura di default: ID che non rivelano nulla, chiavi su tabelle piccole e medie, correlation ID |
| v7 | Tempo Unix a 48 bit in ms, poi contatore e bit casuali | Chiavi primarie su tabelle molto trafficate, ID di eventi e log da ordinare per data di creazione |
| v1 | Tempo gregoriano a 100 ns, sequenza di clock, nodo | Solo quando un sistema legacy pretende v1 |
| v6 | I campi di v1, con il tempo in testa | Sistemi che parlano già v1 ma hanno bisogno di chiavi ordinabili |
| v5 | SHA-1 di namespace + nome | Lo stesso ID ogni volta per lo stesso input: un URL, un dominio, uno SKU |
| v3 | MD5 di namespace + nome | Allinearsi a un sistema più vecchio che usa già v3 |
| Nil / Max | Tutti zeri / tutti uno | Marcatori espliciti di «nessun valore» e limiti di intervallo, mai come chiavi |
La mia regola pratica: v4, a meno che l’ID non sia una chiave di database con molti inserimenti: allora v7. La stessa RFC 9562 dice che, dove possibile, le implementazioni dovrebbero usare v7 al posto di v1 e v6. Il v5 basato su nome fa storia a sé: non punta all’unicità nel tempo ma a ottenere due volte la stessa risposta, ed è esattamente ciò che serve quando due servizi devono concordare l’ID di «https://example.com/item/42» senza parlarsi. La guida v4 vs v7 spiega il lato indice di questa scelta.
Un avvertimento pratico su v7: le sue prime 12 cifre esadecimali sono l’istante di creazione in millisecondi, leggibile da chiunque. Incolla 017f22e2-79b0-7cc3-98c4-dc0c0c07398f nella scheda Valida & decodifica e ottieni il momento esatto in cui è stato creato. Se un ID viene mostrato agli utenti e la tempistica è un dato sensibile, dagli un v4.
Formati: gli stessi 128 bit, sette grafie
La maggior parte degli errori «invalid UUID» che ho inseguito non dipendeva da ID sbagliati, ma solo dalla grafia sbagliata per il sistema dall’altra parte. Il generatore mantiene i bit e cambia solo il testo, così lo stesso valore può finire in ognuno di questi:
| Formato | Esempio | Dove serve |
|---|---|---|
| Standard minuscolo | 6ba7b810-9dad-11d1-80b4-00c04fd430c8 | uuid di PostgreSQL, API JSON, la maggior parte delle librerie; la forma canonica di output |
| MAIUSCOLO | 6BA7B810-9DAD-11D1-80B4-00C04FD430C8 | Strumenti Windows, output di SQL Server |
| {Graffe} | {6ba7b810-9dad-11d1-80b4-00c04fd430c8} | Guid.ToString("B") di .NET, registro di sistema e COM |
| 32 hex, senza trattini | 6ba7b8109dad11d180b400c04fd430c8 | Nomi di file, campi di log compatti |
| URN | urn:uuid:6ba7b810-9dad-11d1-80b4-00c04fd430c8 | XML e standard che vogliono un URI |
| 0x hex | 0x6BA7B8109DAD11D180B400C04FD430C8 | Letterale per una colonna MySQL BINARY(16) |
| Base64 | a6e4EJ2tEdGAtADAT9QwyA== | Archiviazione compatta o token in campi di solo testo |
L’opzione separatore (trattino, nessuno, punto o trattino basso) vale solo per le forme standard, maiuscola e con graffe: un URN con i punti non sarebbe più un URN valido, quindi lo strumento blocca il separatore. In input vale il contrario: RFC 9562 chiede output minuscolo ma input senza distinzione tra maiuscole e minuscole, e il decoder accetta tutte le forme qui sopra tranne Base64. Se ti servono l’ordine dei byte di .NET o le abitudini di SQL Server, leggi UUID vs GUID.
Elenchi in blocco per fixture e file di seed
La scheda In blocco crea da 1 a 10.000 ID alla volta e li esporta come testo semplice, CSV con intestazione uuid, array JSON o un’istruzione INSERT INTO items (id) VALUES … pronta all’uso (rinomina tabella e colonna con le tue). Due dettagli contano più del numero:
- Gli elenchi v7 sono in ordine strettamente crescente. Diecimila ID vengono creati in pochi millisecondi, quindi la maggior parte condivide lo stesso timestamp. Senza contatore, dentro ogni millisecondo uscirebbero in ordine casuale; con il contatore, l’elenco si ordina allo stesso modo come testo e come byte, e la riga informativa conferma «in ordine strettamente crescente».
- v5 e v3 prendono nomi, uno per riga. Incolla una colonna di domini, URL o codici prodotto e ottieni un ID deterministico per riga, identico a quello che restituisce
uuid5()di Python per lo stesso namespace e nome.
Due UUID possono mai essere uguali?
Per gli ID v4 casuali la risposta onesta è «sì, con una probabilità che puoi calcolare per poi smettere di preoccupartene». Con 122 bit casuali, l’approssimazione del paradosso del compleanno dà:
Esempio svolto: crei un miliardo di ID v4, n = 109. Allora n² = 1018, 2 × 2122 ≈ 1,063 × 1037, l’esponente vale circa 9,4 × 10⁻²⁰ e p ≈ 9,4 × 10⁻²⁰. Con mille miliardi di ID siamo a circa 9,4 × 10⁻¹⁴. Servono all’incirca 2,7 × 10¹⁸ ID prima che la probabilità di un solo duplicato arrivi a un mezzo.
Il rischio vero non è mai la matematica, è una sorgente casuale debole: uno snippet copiato che si basa su Math.random(), un processo forkato che riusa il proprio seed, un’immagine di VM clonata con lo stesso stato. Questo generatore di UUID prende ogni bit casuale da crypto.getRandomValues(), il generatore crittografico del browser. Per v7, due generatori indipendenti collidono solo se scelgono lo stesso millisecondo e poi coincidono su circa 73 bit casuali (il contatore parte da 41 bit casuali e altri 32 bit restano casuali). In ogni caso, metti un vincolo di unicità sulla colonna: non costa nulla e trasforma un problema teorico in un errore ben visibile.
Valida e decodifica: che cosa ti dice un ID
Incolla un UUID nella scheda Valida & decodifica e ottieni la forma canonica, la versione, la variante, il tempo incorporato per v1, v6 e v7 (in UTC e nella tua ora locale), la sequenza di clock e il nodo di v1/v6, più le grafie hex per BINARY(16) e Base64. Il controllo del nodo ti dice se un ID v1 porta un nodo casuale (bit multicast attivo, come raccomanda RFC 9562) o qualcosa che sembra l’indirizzo di una vera scheda di rete, cioè una fuga di privacy che è meglio conoscere.
Se invece incolli un’intera colonna, diventa un controllo di elenco: quante righe sono valide, quali no e perché («trovate 31 cifre esadecimali», «i trattini devono dividere le cifre in 8-4-4-4-12»), quanti sono i duplicati, se l’elenco è in ordine crescente e quali versioni contiene. È il modo più rapido che conosco per verificare un file di import prima che finisca contro un indice univoco.
È anche rigoroso dove i vecchi validatori erano approssimativi. Un UUID con cifra di versione 0 non è l’UUID Nil a meno che tutte le 32 cifre siano zero; un ID con la variante legacy di Microsoft (17ª cifra c o d) è ben formato ma la sua cifra di versione non significa nulla, e il risultato lo dice invece di inventarsi una versione.
Salvare gli UUID senza rimpianti
- Usa il tipo nativo.
uuiddi PostgreSQL euniqueidentifierdi SQL Server occupano 16 byte. Una colonna di testo da 36 caratteri occupa più del doppio, nella tabella e in ogni indice che la include. In MySQL usaBINARY(16); il formato 0x ti dà il letterale. - Scegli v7 per chiavi clustered o con molti inserimenti. I nuovi valori v7 finiscono in fondo all’indice invece che su pagine casuali.
- Tieni una sola grafia canonica nella tua API. Minuscolo con trattini. Confronta senza distinzione tra maiuscole e minuscole se accetti input da altri sistemi.
- Non trattare mai un UUID come un segreto. RFC 9562 dice di non dare per scontato che gli UUID siano difficili da indovinare. I link per il reset della password e le chiavi API richiedono un token casuale dedicato.
- Non distribuire v1 con un vero indirizzo MAC. Identifica la macchina e il momento. Questo strumento usa sempre un nodo casuale.
Per le righe di codice che creano UUID in PostgreSQL, JavaScript, Python, Java e C#, vedi come generare un UUID nel codice.
Da dove vengono i bit e come li verifico
Tutto avviene nel tuo browser; la pagina non invia nulla da nessuna parte. I bit casuali arrivano da crypto.getRandomValues(). La versione 7 segue il metodo 1 di RFC 9562 §6.2 con un contatore a 42 bit (lo stesso schema di uuid7() di Python): un nuovo seed casuale a ogni nuovo millisecondo, più uno per ogni ulteriore ID nello stesso millisecondo, e se l’orologio torna indietro viene riusato l’ultimo timestamp, così l’ordine non si rompe mai. Le versioni 1 e 6 contano tick da 100 nanosecondi dall’inizio del calendario gregoriano, aggiungono un tick per ogni ID nello stesso millisecondo e usano un nodo casuale con il bit multicast attivo. Le versioni 5 e 3 calcolano l’hash dei 16 byte del namespace seguiti dal nome in UTF-8 con SHA-1 o MD5 e poi impostano i bit di versione e variante, esattamente come fanno il testo della RFC 9562 e il modulo uuid di Python.
Lo script precedente di questo sito aveva un bug vero che vale la pena confessare: il calcolo del timestamp v1 andava in overflow su un intero a 32 bit con segno, quindi per circa metà di ogni intervallo di sette minuti produceva ID che iniziavano con un segno meno. Anche il suo output v7 usciva non ordinato all’interno di un millisecondo. Entrambi i problemi sono risolti, e questi sono alcuni dei casi di controllo su cui il generatore di UUID viene testato a ogni modifica:
| Input | Risultato atteso |
|---|---|
v5, namespace DNS, nome python.org | 886313e1-3b8a-5372-9b90-0c9aee199e5d |
v3, namespace DNS, nome python.org | 6fa459ea-ee8a-3ca4-894e-db77e160355e |
v5, namespace URL, https://uuid-generator.net/ | dc63ab62-ce65-5436-9a00-37417044f8cf |
| v1 al tempo Unix 1791450549290 ms | inizia con ebbc68a0-c2f7-11f1 (il vecchio script stampava -14439760-…) |
Decodifica di 017f22e2-79b0-7cc3-98c4-dc0c0c07398f | v7, 2022-02-22 19:22:22.000 UTC |
Decodifica di c232ab00-9414-11ec-b3c8-9f6bdeced846 | v1, stesso istante, sequenza di clock 13256, nodo casuale |
| 10.000 ID v7 nello stesso millisecondo | tutti unici, in ordine strettamente crescente |
| UUID del namespace DNS in Base64 | a6e4EJ2tEdGAtADAT9QwyA== |
Il decoder legge il tempo che un UUID dichiara di contenere. Nulla impedisce a qualcuno di scrivere un timestamp qualsiasi in un v7, quindi considera il tempo decodificato un’informazione, non una prova.
Guide
 UUID v4 vs v7: which one belongs in your primary keyRandom v4 or time-ordered v7? What each does to a B-tree index, what v7 reveals about your rows, and a safe way to switch.Reading time: 7 min
 UUID vs GUID: the same 128 bits with different habitsSame standard, different habits: braces, upper case, the old Microsoft variant, and the byte swap that breaks GUIDs on their way out of .NET.Reading time: 6 min
 How to generate a UUID in PostgreSQL, JavaScript, Python, Java and C#The v4 one-liner, the v7 option and the name-based call in five languages, plus what MySQL and SQL Server do differently.Reading time: 6 min
Domande frequenti
Un UUID generato qui è davvero unico?
Ogni ID v4 contiene 122 bit casuali presi dal generatore crittografico del tuo browser; anche su un miliardo di ID la probabilità di collisione è intorno a 9,4 × 10^-20. Non viene salvato né inviato nulla, quindi nessun altro vede mai i tuoi ID.
Conviene usare UUID v7 come chiave primaria?
Per tabelle con molti inserimenti, sì: v7 inizia con un timestamp in millisecondi, quindi le nuove chiavi finiscono vicine nell’indice. Resta su v4 quando l’ora di creazione non deve essere visibile a chi vede l’ID.
GUID e UUID sono la stessa cosa?
Sì, GUID è il nome che Microsoft dà allo stesso identificatore a 128 bit. Le differenze sono abitudini: maiuscole, parentesi graffe e un ordine dei byte little-endian per i primi tre gruppi in .NET e SQL Server.
Come ricavo il timestamp da un UUID?
Incollalo nella scheda Valida & decodifica. Le versioni 1, 6 e 7 contengono un timestamp e lo strumento lo mostra in UTC e nella tua ora locale; v4 e v5 non contengono alcun tempo.
Perché lo stesso nome dà sempre lo stesso UUID v5?
Un UUID v5 è un hash SHA-1 del namespace e del nome, quindi è deterministico per costruzione. Cambia un carattere, il namespace o una barra finale in un URL e ottieni un ID diverso.
Gli UUID distinguono tra maiuscole e minuscole?
No. RFC 9562 chiede ai generatori di produrre output in minuscolo e ai parser di accettare entrambe le forme. Salva una sola grafia e confronta senza distinzione tra maiuscole e minuscole quando gli ID arrivano da altri sistemi.
Aggiornato il